华硕宣布推出 ASUS Ascent GX10 的新款 64GB 配置版本

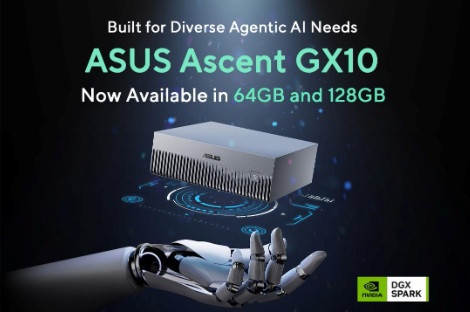
华硕今日宣布推出 ASUS Ascent GX10 的全新 64GB 配置版本,进一步丰富了现有的 128GB 产品阵容。这款紧凑型 AI 超级计算机旨在让更多开发者、研究人员和数据科学家能够触及本地智能体 AI(agentic AI)的开发工作。ASUS Ascent GX10 64GB 基于 NVIDIA DGX Spark™ 平台构建,并搭载完整的 NVIDIA AI 软件栈;它不仅沿用了 128GB 版本所具备的千万亿次级(petaflop-scale)算力架构,更采用了专为当今高效开源模型优化的内存配置——足以构建并运行目前性能最强的 300 亿至 350 亿参数(30–35B)级模型及自主智能体。当工作负载增加时,用户可通过 NVIDIA Sync Cluster Assistant 将两台系统组建成集群,从而获得 128GB 的共享内存池以及约 1.7 倍的吞吐量。
“无处不在的 AI”,专为更多构建者打造
秉承“无处不在的 AI,无限可能”(Ubiquitous AI. Incredible Possibilities.)的战略,华硕致力于让智能体 AI 触手可及,惠及每一位构建者。这不仅包括那些已在本地运行前沿级模型的专业 AI 团队,更涵盖了规模庞大的早期大众群体——即那些准备着手实践的开发者、研究人员及对 AI 充满好奇的团队。
ASUS Ascent GX10 64GB 正是为这一群体量身打造的,为他们提供了一个更易于切入 NVIDIA DGX Spark 平台的途径,助力更多人从单纯的好奇转向实质性的智能体 AI 开发。与此同时,ASUS Ascent GX10 128GB 版本将继续服务于那些运行超大规模本地模型及处理高强度工作负载的团队。
面向 AI 智能体时代的本地基础设施
智能体 AI 彻底改变了企业使用 AI 的方式:AI 不再仅仅是人们进行查询的工具,而已演变为能够自主规划、调用工具并执行复杂多步骤任务的系统。随着业界各类框架推动智能体从原型阶段走向日常生产工作负载,Token(标记)消耗量激增,这不仅推高了云端推理成本,也引发了关于机密商业数据及知识产权如何通过公共 API 传输的新议题。在本地硬件上运行开源模型,使团队能够将 Token 生成过程和数据保留在内部,同时不牺牲智能体(Agentic)工作流所要求的高性能。随着智能体 AI 扩展到更多用户和应用场景,强大的本地系统正成为基础设施的必备要素,而 ASUS Ascent GX10 64GB 正是为满足这一需求而打造的。
释放 AI 潜能
ASUS Ascent GX10 64GB 带来毫不妥协的本地 AI 体验。其统一架构消除了性能瓶颈,构建了强大的内存池,为最新、最强大的大语言模型(LLM)提供了理想的运行环境,确保智能体 AI 工作负载发挥巅峰性能。
Petaflop 级性能,完美适配当今模型
ASUS Ascent GX10 64GB 基于 NVIDIA DGX Spark 平台构建,其核心搭载了与原版 Ascent GX10 相同的 NVIDIA GB10 Grace Blackwell 超级芯片(Superchip)。该芯片将配备第五代 Tensor Core 和 FP4 支持的 Blackwell GPU 与 20 核 NVIDIA Grace Arm CPU 完美结合。GB10 超级芯片利用 NVIDIA NVLink-C2C 技术,实现了 CPU 与 GPU 统一的内存模型,其带宽高达 PCIe® Gen 5 的 5 倍。这使得这款紧凑、节能且仅需标准墙壁插座供电的设备,能够提供高达 1 Petaflop 的 AI 算力——是全天候运行智能体应用的理想选择。
64GB 统一内存
ASUS Ascent GX10 64GB 配备了 64GB LPDDR5x 统一内存,提供 273GB/s 的内存带宽,为开发者、研究人员和 AI 爱好者提供了一个完美适配新一代高效开源模型的平台。诸如 Qwen3.8-27B 等 AI 模型,如今仅需 ASUS Ascent GX10 64GB 轻松容纳的内存容量,即可实现媲美数月前顶尖模型(Frontier Models)的性能表现。 ASUS Ascent GX10 64GB 搭载了与 128GB 版本相同的 NVIDIA DGX Spark 平台,但提供了更灵活、入门门槛更低的方案,支持本地 AI 实验、模型开发及推理;而 128GB 版本则凭借更大的内存容量,能够应对要求更高的 AI 工作负载。
按需扩展
ASUS Ascent GX10 64GB 专为适应开发者工作负载的增长而设计。利用系统内置的 NVIDIA ConnectX-7 网络技术,两台 Ascent GX10 64GB 单元可进行集群互联,从而实现高达 128GB 的统一内存、2 PFLOPS(千万亿次浮点运算)的 AI 算力以及 546GB/s 的总内存带宽——其性能最高可达单台 ASUS Ascent GX10 128GB 系统的 1.7 倍。通过集群部署并结合对 NVIDIA NVFP4 格式的支持,用户能够运行更大规模模型的压缩版本(例如 Qwen3.8-Flash-Next)。借助 NVIDIA Sync App 及其 Cluster Assistant 功能,仅需数分钟即可完成设置,且无需更改软件环境或工作流程。
这种横向扩展设计为团队提供了清晰的升级路径:初期可使用单台 ASUS Ascent GX10 64GB 进行原型设计与推理,随后随着模型规模、上下文窗口及并发智能体(agents)需求的增加,可灵活添加更多单元进行集群扩展——同时确保模型、提示词(prompts)及数据始终保留在本地设备上。
精密打造,实现卓越散热效率
ASUS Ascent GX10 64GB 沿用了精心设计的散热架构搭载 ASUS Ascent GX10 128GB,并针对高负载 AI 任务及智能体(agent)长时间运行期间的持续高性能表现进行了优化。其先进的散热系统具备 7 级风扇控制、超宽散热鳍片、五根热管以及两个 140x80mm 风扇;风扇通过隐蔽的底部进气口吸入空气,从而实现强劲且高效的气流循环。
ASUS Ascent GX10 64GB 预装了基于 NVIDIA DGX OS 的完整 NVIDIA AI 软件栈(包括 PyTorch、Jupyter 和 Ollama),以及用于实现基于策略的智能体安全性的 NVIDIA OpenShell 和 NVIDIA NemoClaw;此外,该设备还内置了基于 SSH 的远程管理功能,便于 IT 团队在现有基础设施之上对系统集群进行部署与监控。
从个人智能体计算机到企业级 AI 基础设施
华硕正将其智能体 AI(agentic AI)技术扩展至丰富多样的本地系统产品线中。搭载 NVIDIA RTX Spark 的 ProArt 笔记本电脑和迷你 PC 可作为个人前端 AI 工作站,支持内容创作、智能体交互、应用程序控制及工作流开发。搭载 NVIDIA DGX Spark 的 ASUS Ascent GX10 进一步增强了本地 AI 开发与模型原型设计能力;而搭载 NVIDIA DGX Station 的 ASUS ExpertCenter Pro ET900 则能够应对更大规模的专业级及企业级工作负载。
上市信息与价格
ASUS Ascent GX10 64GB 在马来西亚市场的上市详情将择日公布。


